Ich wollte ausprobieren, wie weit sich ein überschaubares, aber reales Softwareprojekt heute von Agenten weitgehend selbstständig entwickeln lässt.
Ich wollte ausprobieren, wie weit sich ein überschaubares, aber reales Softwareprojekt heute von Agenten weitgehend selbstständig entwickeln lässt. Nicht mit einem hingeworfenen Prompt und anschließendem Vibe Coding, sondern mit Recherchephase, Produktdefinition, Backlog, strukturierten Stories, Akzeptanzkriterien, Definition of Done, Tests und einem Double Check für jeden Arbeitslauf.
Nach ungefähr acht Stunden stand ein erstaunlich brauchbares Produkt, aber keines, das ich weiterentwickeln und einsetzen wollte. Das lag weniger am Code als an den Entscheidungen, die der Agent unterwegs selbst traf, bis hin zu einem kompletten webbasierten Inspector, den ich nie bestellt hatte.
Nachfolgend beschreibe ich, wie ich vorgegangen bin und was mir aufgefallen ist. Dabei habe ich bewusst keine Parallelisierung angestrebt, Claude Code das aber auch nicht verboten. Ich wollte schrittweise ansehen, wie es sich entwickelt, ohne durch Agentenschwärme noch weitere Komplexität in das Setting einzubringen.
Ein geeignetes Versuchsobjekt
Ausgangspunkt war ein Workshop, für den ich mit einem in Qt entwickelten Modell eines Landmaschinenterminals gearbeitet hatte. Daraus entstand die Idee, eine Bibliothek zur Automatisierung nativer Anwendungen zu bauen: eine Playwright-artige API für native Desktop-Anwendungen statt für Browser, zunächst für Qt, Java und GTK. Damit sollte man Anwendungen ansprechen, native Objekte finden, Properties lesen, Aktionen ausführen und daraus verständliche automatisierte Tests bauen können.
Zur praktischen Testautomatisierung gehört aber mehr als die API. Wer eine fremde Anwendung automatisieren will, muss sie untersuchen, Objekte identifizieren, ihre Eigenschaften ansehen und daraus Selektoren und Tests entwickeln können. Deshalb sollten auch die üblichen Productivity Tools dazugehören. Das Projekt bekam den Namen AUTWire.
GUI-Automatisierung ist kein neues Problem. Es gibt seit Jahrzehnten Produkte und Bibliotheken dafür und für viele Bedienkonzepte reichlich Anschauungsmaterial. Das war beabsichtigt, denn ich wollte nicht gleichzeitig ein neues Produktproblem lösen und die Arbeit mit Agenten untersuchen. Zugleich gab es genug Stellen, an denen ich eigene Vorstellungen hatte. Dort würde sich hoffentlich zeigen, was passiert, wenn der Agent nicht einfach ein bekanntes Konzept neu implementieren kann.
Der erste Ansatz
Mein Plan bestand zunächst aus zwei oder drei größeren Prompts, die Produkt und Arbeitsweise möglichst genau beschreiben sollten. Danach sollte Claude das Projekt weitgehend selbstständig entwickeln.
Die kritische Stelle sah ich in diesen Ausgangsprompts. Arbeiten Agenten über Stunden selbstständig, entsteht für den Auftraggeber zwangsläufig eine Art Fog of War. Ich kann nicht jede kleine Entscheidung verfolgen und will das auch nicht, sonst könnte ich die Software gleich selbst entwickeln. Also steckte ich viel Arbeit in die Prompts.
Dabei stößt man schnell auf ein altes Problem: Eine vollständige Spezifikation gibt es praktisch nicht. Man kann Anforderungen sorgfältig formulieren und nach Widersprüchen durchsuchen, auch mit Hilfe eines Sprachmodells, was ich getan habe. Trotzdem bleiben Lücken. Manche technischen Konsequenzen zeigen sich erst bei der Implementierung, manche Anforderungen erweisen sich als unnötig, andere fehlen und fallen erst beim Benutzen auf. Was weder in der Spezifikation steht noch aus dem Kontext abgeleitet werden kann, wissen auch Agenten nicht, und ein größerer Prompt ändert daran nichts. Deshalb sollte Claude nicht sofort programmieren.
Recherche und Produktdefinition
Am Anfang stand eine Recherchephase. Claude untersuchte existierende Lösungen, ihre Konzepte und ihren Funktionsumfang. Wir besprachen, was davon für AUTWire sinnvoll war und wo ich andere Vorstellungen hatte. Daraus entstand eine recht genaue Produktvorgabe, die auch Tooling und Teststruktur umfasste. Features wurden gesammelt, diskutiert, ergänzt oder verworfen und anschließend in Stories zerlegt.
Im Filesystem lag ein einfaches Board mit Backlog, laufenden und abgeschlossenen Arbeiten. Darüber konnte ich jederzeit sehen, woran Claude gerade arbeitete und was als erledigt galt. Die Stories hatten Akzeptanzkriterien und eine Definition of Done, Tests gehörten selbstverständlich dazu. Zu jedem Arbeitslauf gehörte außerdem ein Double Check: Claude sollte vor beziehungsweise nach seiner Arbeit prüfen, ob Auftrag, Regeln, Implementierung und Ergebnis zusammenpassten.
Naiv im Sinne eines Einzeilers à la „Bau mir ein Open-Source-Squish“ war der Ansatz damit nicht. Naiv war eher meine Vorstellung davon, was damit bereits hinreichend geregelt war.
Acht Stunden später
Nach der Vorbereitung ließ ich Claude im Wesentlichen arbeiten. Ich verfolgte den Fortschritt und besprach an den vorgesehenen Stellen Entscheidungen oder Ergebnisse, griff aber nicht laufend in die Implementierung ein.
Das Ergebnis war ein erstaunlich vollständiger Softwarestand. Native Anwendungen ließen sich ansprechen, Objekte finden, Eigenschaften lesen und Aktionen ausführen. Es gab Tests und erste Werkzeuge rund um die Bibliothek. Und das Ganze lief nicht nur gegen eine eigens gebaute Demo, sondern auch gegen die Qt-Anwendung, aus der die Idee stammte. Auch der Code war keineswegs schlecht und hätte in einem normalen Review kaum Anlass zu größerer Kritik gegeben.
Trotzdem wirkte das Ergebnis eher wie ein sehr guter Proof of Concept als wie der Anfang eines Produkts, das ich über längere Zeit weiterentwickeln wollte. Interessant war, wo dieser Eindruck entstand.
Bekanntes war deutlich einfacher
Die Teile, für die es gute Vorbilder gab, waren überwiegend gelungen. Für eine Playwright-artige API gibt es Playwright, für GUI-Automatisierung etablierte Produkte. Locator, Actions, Properties und viele andere Grundkonzepte musste Claude nicht neu erfinden, dafür gibt es Dokumentation, Quellcode, Beispiele und gewachsene Konventionen.
Schwieriger wurde es, wo meine Vorstellungen von den bekannten Lösungen abwichen, vor allem bei Teilen des Toolings und bei Abläufen ohne offensichtliches Vorbild. Auch dort entstanden meist funktionierende Lösungen. Sie wirkten aber zunehmend wie gute Antworten auf die jeweilige Story und weniger wie Teile eines konsequent entworfenen Gesamtprodukts. Die eigentliche Schwierigkeit lag also nicht in der Codeerzeugung.
Was nicht spezifiziert ist, muss trotzdem entschieden werden
Während der Implementierung muss ständig entschieden werden, wie eine ungenaue Anforderung zu verstehen ist, welche Abstraktion sinnvoll ist, wo eine Verantwortlichkeit liegt oder ob ein zusätzliches Werkzeug gebraucht wird. Das ist bei einem menschlichen Entwickler nicht anders, und ohne solche Entscheidungen stünde die Entwicklung still.
Claude traf diese Entscheidungen meist plausibel. Gerade deshalb war das Problem anfangs schwer zu erkennen.
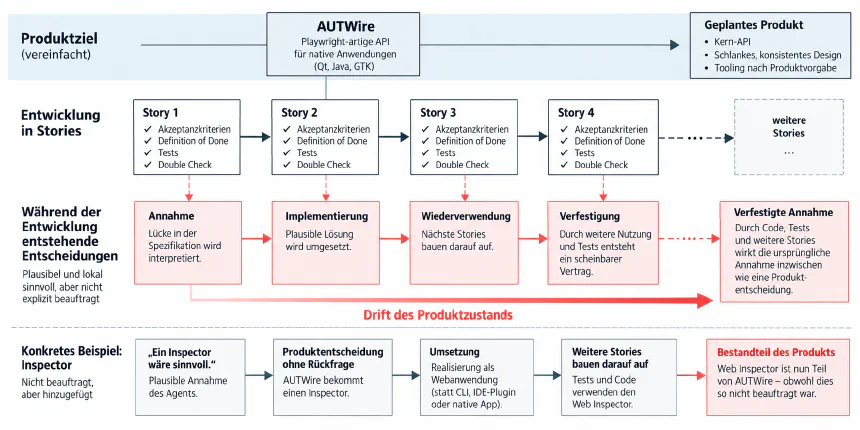
Ein Mechanismus wurde für eine Story eingeführt, die Story war danach grün. Für eine spätere Story war er bereits Teil des Repositorys und damit des vorgefundenen Kontexts. Also wurde darauf aufgebaut, weitere Komponenten verwendeten ihn, und irgendwann sicherten Tests sein Verhalten ab. Aus einer Annahme wurde so eine Implementierung, daraus ein scheinbarer Vertrag und schließlich etwas, das wie eine gewollte Produkteigenschaft aussah. Niemand hatte beschlossen, dass es zum Produkt gehören sollte. Es war im Laufe der Entwicklung einfach dazu geworden.
Der Inspector, den ich nicht bestellt hatte
Besonders anschaulich wurde das beim Tooling. Claude stellte fest, dass man für die Automatisierung einer unbekannten nativen Anwendung ein Werkzeug braucht, mit dem sich deren Objekte untersuchen lassen. Das stimmt, und Claude folgerte daraus, dass AUTWire einen Inspector braucht.
So beauftragt hatte ich das nicht. Er fragte auch nicht nach, sondern baute ihn und traf dabei gleich die nächste Entscheidung: Der Inspector wurde eine Webanwendung. Auch dafür gibt es gute Argumente. Eine Weboberfläche ist schnell gebaut, ein Browser ist überall vorhanden, und man braucht kein weiteres natives UI-Framework.
Ob das Produkt aber überhaupt einen eigenständigen Inspector bekommt und ob dieser als native Anwendung, Kommandozeilenwerkzeug, IDE-Integration oder Webanwendung umgesetzt wird, ist keine nebensächliche Implementierungsfrage. Das betrifft das Produkt selbst. Der Inspector funktionierte grundsätzlich, sah allerdings ziemlich gruselig aus und entsprach weder gestalterisch noch konzeptionell dem Werkzeug, das ich haben wollte.
Claude hatte keinen Unsinn gebaut, sondern ein reales Problem erkannt und plausibel gelöst. Nur hatte er dabei mehrere Entscheidungen getroffen, über die wir nie gesprochen hatten. Die fehlende Grenze lag nicht zwischen „richtig“ und „falsch“, sondern zwischen einer Implementierungsentscheidung, die ein Entwickler selbstverständlich selbst trifft, und einer Produktentscheidung, die ich vorher sehen wollte.
Aus lokalen Entscheidungen wurde Drift
Andere Fälle waren unscheinbarer: eine zusätzliche Abstraktion hier, die Auslegung einer nicht ganz eindeutigen Anforderung dort, ein ursprünglich provisorischer Mechanismus an anderer Stelle. Keine davon musste schlecht sein, einige waren sogar ziemlich vernünftig. Das Problem entstand durch ihre Anhäufung.
Nach genügend Stories bestand AUTWire nicht mehr nur aus meinen Anforderungen und den dafür nötigen technischen Entscheidungen, sondern zunehmend aus Produkt- und Architekturentscheidungen, die Claude unterwegs selbst getroffen hatte. Jede weitere Story baute darauf auf. Das war die Drift, die mir zunehmend auffiel.
Das Board sah trotzdem gut aus
Auf dem Board war davon wenig zu sehen. Jede Story war umgesetzt, Akzeptanzkriterien und Definition of Done waren erfüllt, die Tests grün, der Double Check ohne wesentlichen Befund. Die Story wanderte nach Done, die nächste konnte beginnen.
Das war korrekt und trotzdem nicht ausreichend. Ein Board betrachtet Arbeitspakete, das Produkt enthält die Summe der Entscheidungen, die bei ihrer Bearbeitung getroffen wurden. Eine Entscheidung kann für Story 5 völlig vernünftig sein. Story 8 baut darauf auf, Story 12 verallgemeinert den Mechanismus. Alle drei erfüllen ihre Akzeptanzkriterien, und trotzdem kann daraus eine Architektur entstehen, die niemand bewusst so beschlossen hat. Das ist ein anderes Problem als eine fehlerhaft implementierte Story.
Mehr Reviews sollten Sicherheit schaffen
Ich wollte eine unabhängige Einschätzung und ließ weitere Agenten das Projekt nach den üblichen Maßstäben professioneller Softwareentwicklung reviewen. Die Reviews fanden Probleme, die untersucht und behoben wurden. Der nächste Review fand neue Punkte, die oft ebenfalls technisch plausibel waren.
Nach mehreren Durchläufen zeigte sich eine unerwünschte Nebenwirkung: Der Reviewprozess konnte selbst neue Drift erzeugen. Ein Reviewer stellte zum Beispiel eine Verantwortlichkeit infrage, und die Korrektur führte zu einer neuen Abstraktion. Ein späterer Reviewer fand in diesem veränderten Stand eine andere Inkonsistenz und änderte die Struktur erneut. So wurden Architekturentscheidungen wieder geöffnet, Verantwortlichkeiten verschoben und Begriffe geändert. Keine einzelne Änderung musste offensichtlich falsch sein, aber das Gesamtsystem wurde dadurch nicht automatisch besser.
Wenn aus Review sofort Entwicklung wird
Der interessante Punkt lag im Übergang vom Finding zur Änderung. Agenten können eine verdächtige Stelle finden, eine mögliche Ursache analysieren und Sekunden später die vermeintlich richtige Korrektur implementieren. In einem klassischen Reviewprozess trennt häufig schon der Ablauf diese Schritte: Ein Reviewer kommentiert einen Pull Request, der Entwickler bewertet das Finding, reproduziert das Problem und arbeitet gegebenenfalls nach, bei größeren Konsequenzen mit weiteren Personen. Bei Agenten können dieselben Schritte ohne erkennbare Grenze im selben Kontext ablaufen.
Für die weitere Arbeit hat es sich deshalb bewährt, Finding, Diagnose und Reparatur ausdrücklich zu trennen. Ein Finding ist zunächst eine Beobachtung oder ein begründeter Verdacht. Danach wird geprüft, ob die vermutete Ursache stimmt. Erst dann stellt sich die Frage, welche Änderung folgen soll und wer das entscheiden darf. Nötig war das nicht wegen schlechter Reparaturvorschläge, sondern weil ein Review sonst sehr schnell wieder zur Entwicklungssession mit neuen Entscheidungen wurde.
Auch Tests konservieren Entscheidungen
Getestet wurde von Anfang an: Neue Funktionen bekamen Tests, Fehler Regressionstests. Ein grüner Test beantwortet aber nur die Frage, die in ihm formuliert ist. Interpretieren Agenten eine Anforderung, leiten daraus einen Test ab und schreiben dann die Implementierung, weist der Test zuverlässig nach, dass die Implementierung zur Interpretation passt. Ob die Interpretation stimmt, ist damit nicht geklärt.
In einer frühen Phase gab es zum Beispiel einen Mechanismus, der Informationen über die Objektstruktur einer Qt-Anwendung ausgab. Für den damaligen Proof of Concept war das hilfreich. Später verwendeten Tests dieses Verhalten, und weil Tests davon abhingen, sah das temporäre Hilfsmittel zunehmend wie ein notwendiger Bestandteil des Produkts aus. Der Test war nicht falsch. Fraglich war, ob dieses Verhalten überhaupt dauerhaft zum Produkt gehören sollte.
Das hatte ich vorher so nicht auf dem Schirm: Tests können nicht nur Anforderungen absichern, sondern auch vorläufige Annahmen konservieren.
Ein anderer Reviewansatz
Später habe ich deshalb ein anderes Reviewverfahren ausprobiert. Ein Agent bekam einen vermeintlich fertigen Stand in einem unabhängigen Kontext und durfte ihn ausschließlich untersuchen. Er sollte nichts reparieren und nichts weiterentwickeln, sondern versuchen, das Ergebnis zu widerlegen.
Technisch sah der Stand ordentlich aus. C++- und Python-Tests waren grün, die Integrationstests liefen, die Static Analysis war sauber, und Mutation Testing hatte fast alle eingebauten Veränderungen erkannt.
Der Reviewer fand trotzdem einen reproduzierbaren Crash. Die Ursache lag in einer Kombination aus Qt-Lebensdauerregeln, dem verschachtelten Event Loop eines modalen Dialogs und einem Client-Disconnect. Unter genau diesen Bedingungen konnte ein Socket bereits gelöscht sein, bevor der ursprüngliche Request-Handler ihn erneut verwendete. Diesen Zustandsübergang hatten die vorhandenen Tests nicht erzeugt.
Nach der Diagnose bekam der Fehler einen Regressionstest und wurde behoben. Aus einem unbekannten Fehlermuster war eine bekannte Invariante geworden, die eine Test-Suite billiger und zuverlässiger überwachen kann als ein kreativer Reviewer. Das ergibt eine sinnvolle Aufgabenteilung: Automatisierte Tests bewachen bekannte Erwartungen und Invarianten. Ein unabhängiges Review sucht gezielt nach dem, woran beim Aufbau dieser Prüfungen noch niemand gedacht hat.
Gut, aber nicht production ready
Als Proof of Concept hätte ich das Ergebnis vermutlich ohne große Einschränkungen akzeptiert. Mein Ziel war aber eine Bibliothek samt Tooling, die ich weiterentwickeln und in eigenen Projekten einsetzen konnte, und dafür war der Stand nicht production ready. Nicht wegen eines katastrophalen Fehlers oder schlechten Codes, sondern wegen der Menge an Nacharbeit. Einige technische Entscheidungen hätten überprüft werden müssen, andere wollte ich zurücknehmen. Provisorien hatten sich verfestigt, Teile des Toolings entsprachen nicht meinen Vorstellungen. An einigen Stellen war nicht mehr zu erkennen, welche Entscheidungen aus meinen Anforderungen stammten und welche unterwegs hinzugekommen waren.
Claude hatte meinen Auftrag dabei nicht schlecht ausgeführt. Oft hatte er ihn sinnvoll ergänzt, Lücken geschlossen und Probleme selbstständig gelöst. Ohne diese Fähigkeit wäre autonome Entwicklungsarbeit gar nicht möglich. Ich hatte nur nicht geklärt, welche Lücken er selbst schließen sollte und bei welchen er mich fragen musste.
Mein Fazit
Der Versuch hat für mich vor allem gezeigt, dass ein guter Ausgangsauftrag, ein strukturierter Entwicklungsprozess und die Absicherung durch Tests, Double Checks und Reviews auch bei der Arbeit mit Coding Agents notwendig sind. Sie lösen aber nicht das ganze Problem.
Eine Spezifikation kann nicht alle Entscheidungen vorwegnehmen, die während der Entwicklung entstehen. Stories und Akzeptanzkriterien stellen sicher, dass einzelne Arbeitspakete ihr Ziel erreichen, erfassen aber nicht automatisch die Auswirkungen vieler lokaler Entscheidungen auf das Gesamtsystem. Tests können eine vorläufige oder falsche Annahme genauso zuverlässig absichern wie eine richtige. Und ein Review schafft nicht automatisch Kontrolle, wenn aus einem Finding unmittelbar die nächste Produkt- oder Architekturentscheidung entsteht.
Claude konnte in erstaunlich kurzer Zeit viel brauchbare Software entwickeln. Gerade deshalb halte ich die Frage, ob Coding Agents programmieren können, inzwischen für wenig interessant. Spannender ist, unter welchen Bedingungen man ihnen diese Arbeit überlassen kann.
In meinem Versuch war sehr genau beschrieben, was entwickelt werden sollte und wie die Arbeit organisiert war. Wesentlich weniger genau war geregelt, welche Entscheidungen der Agent während dieser Arbeit selbst treffen durfte, welche bereits getroffen waren und an welchen Stellen er hätte nachfragen müssen.
Genau dort liegt für mich inzwischen die eigentliche Aufgabe: Nicht nur die Arbeit zu spezifizieren, sondern auch die Entscheidungsgrenzen, innerhalb derer ein Agent selbstständig entwickeln kann.
Die Versuche werden fortgesetzt.