KI erzeugt Code in Minuten. Warum der Engpass dadurch nicht verschwindet, sondern sich verschiebt — und was das für die Qualitätssicherung bedeutet.
Als das mit der generativen KI in der Öffentlichkeit losging, war ich sofort elektrisiert. Im Studium hatte ich mit Expertensystemen, Prolog und einfachen neuronalen Netzen experimentiert, später für Kunden Seminare zu Data Analytics und ML-Verfahren gehalten. Aber das hier war etwas anderes. Und ich gebe zu: Ich bin auch heute noch fasziniert, was da geht.
Also habe ich mit den verfügbaren Sprachmodellen herumexperimentiert. Von den ersten selbstgebastelten Chatbots über eigene Agenten bis zu Versuchen, den Systemen ein besseres Gedächtnis zu geben oder RAG einzusetzen. Dabei habe ich viel gelernt, auch über die Zusammenarbeit mit KI — oder, etwas weniger anthropomorph gesagt, über die Nutzung eines sehr leistungsfähigen Werkzeugs.
Die KI kann dabei viele Rollen einnehmen. Am meisten gefällt mir die des Enablers. Ich habe Ideen und Konzepte, manche schon uralt. Für einige fehlen mir die Kenntnisse, andere müssen noch tiefer durchdacht werden — und neben Familie und Beruf fehlt meistens schlicht die Zeit, sich daran zu wagen.
Da kommt die KI ins Spiel. Erst mit ChatGPT im Frage-und-Kopier-Verfahren, heute mit Claude Code oder einem selbstgebauten Agenten kann ich mir Wissensgebiete erschließen und Code-Experimente machen, von denen ich früher nur träumen konnte. Nicht mehr erst Unmengen Boilerplate produzieren. Einen Ansatz ausprobieren, verwerfen und einen anderen dagegenstellen. Abhängigkeiten suchen lassen. Sich auch mal an eine Sprache wagen, mit der man bisher wenig zu tun hatte.
Das ist großartig. Die vergangenen Jahre waren deshalb eine Zeit der Entdeckung, und sie waren lehrreich — auch im Hinblick auf die Frage, was das für mein Spezialgebiet bedeutet, die QA. Davon möchte ich hier berichten.
Je überzeugender die Antwort, desto genauer sollte man hinschauen
„Entschuldigung, wie komme ich zum Bahnhof?" – „Immer geradeaus, an der Ampel links, dann sehen Sie ihn schon." Zwanzig Minuten später steht man in einem Gewerbegebiet zwischen einer Autolackiererei und einem Zaun.
Der Mann hat nicht gelogen. Er war sich sicher.
Das ist die unangenehmste Sorte falscher Auskunft. Wer zögert, die Stirn runzelt und dann danebenliegt, hat einen immerhin gewarnt. Wer im vollen Brustton antwortet, nimmt einem die Gelegenheit, misstrauisch zu werden. In der Arbeitspsychologie hat das einen Namen: Automation Bias beschreibt die Neigung, automatisierten Ausgaben zu stark zu vertrauen und sie deshalb nicht ausreichend zu überprüfen. Das war schon in Cockpits ein Thema, lange bevor jemand von Sprachmodellen sprach.
Bei einem Sprachmodell kommt beides zusammen. Eine Antwort kann vollständig aussehen, sauber formuliert sein und trotzdem falsch liegen. Das Gefährliche daran ist nicht der Fehler. Es ist die fehlende Warnlampe. Ein Mensch sagt irgendwann „keine Ahnung" oder fragt nach. Ein Modell kann das auch, aber ich kann mich nicht darauf verlassen. Es gibt kein verlässliches Signal, das mir sagt: Ab hier wird geraten.
Interessant wird das, sobald die Antwort keine Auskunft mehr ist, sondern Code.
Aller Anfang ist beeindruckend
Wer heute mit Claude Code, ChatGPT oder Gemini arbeitet, bekommt eine fertige Funktion in der Zeit, die früher für das Drumherum draufging. Meistens sogar die, die man gemeint hat, mit Fehlerbehandlung, mit Tests, mit Kommentaren.
Die Eintrittshürde ist gefallen. Leute, die nie programmiert haben, bauen sich Werkzeuge. Leute, die programmieren können, kommen endlich zu Dingen, für die vorher nie Zeit war.
Daraus entsteht ein Gedanke, der sich fast von selbst aufdrängt: Wenn Code plötzlich so viel schneller erzeugt werden kann, müsste doch die ganze Entwicklung schneller und billiger werden. Genau da wird es interessant.
Der Engpass wandert
Früher war der Ablauf übersichtlich. Jemand hatte eine Idee, jemand baute sie, danach schaute jemand nach, ob sie stimmt, dann ging sie live. Der Teil, der am längsten dauerte, war das Bauen. Wer ein Projekt beschleunigen wollte, beschleunigte das Bauen.
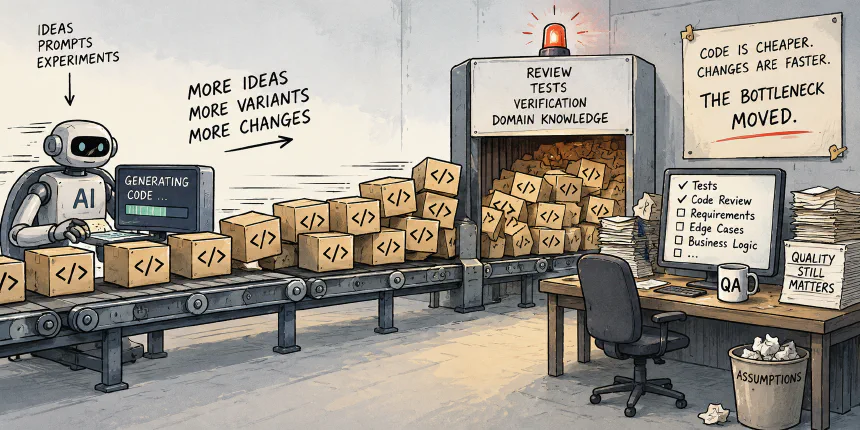
Genau dieser Teil ist jetzt zusammengeschrumpft. Der Rest nicht im gleichen Maß. Zwischen „der Code ist da" und „der Code geht in Produktion" steht noch immer dieselbe Frage — nur ist sie inzwischen der langsamste Schritt im ganzen Ablauf: Woher weiß ich, dass das stimmt?
- Idee
- Entwicklung
- Prüfung
- Live
- Idee
- LLM erzeugt Code in Minuten
- Woher weiß ich, dass das stimmt?
- Live
Der Engpass ist nicht mehr die Entwicklung. Der Engpass ist das Vertrauen.
Was der schnelle Kollege nicht weiß
Zurück zu dem Mann an der Straßenecke. Sein Problem war nicht, dass er dumm war. Er hat die Frage beantwortet, die er verstanden hat. Vielleicht gibt es in der Stadt zwei Bahnhöfe. Vielleicht meinte er den, den er selbst benutzt, und für ihn stimmte die Auskunft sogar.
Ein Modell arbeitet nach demselben Muster. Es erzeugt eine Lösung für das Problem, das sich aus Prompt, Kontext und den sonst verfügbaren Informationen ergibt. Ob das unser Problem war, ist eine andere Frage. Es kennt den Randfall nicht, der in diesem Fachbereich seit Jahren Ärger macht, wenn wir ihm nichts davon erzählen. Es kennt die Ausnahme im Geschäftsprozess nicht, die nirgends dokumentiert ist, weil sie alle Beteiligten im Kopf haben. Und wo eine Anforderung eine Lücke hat, wird diese Lücke gefüllt.
Genau dort entstehen Lösungen, die sauber aussehen und vollständig wirken — nur leider zur falschen Annahme.
Das ist für mich einer der entscheidenden Punkte beim AI Coding: Plausibilität ist kein Nachweis für Korrektheit.
Ein unerfahrener Kollege fragt irgendwann nach, wenn er nicht weiterweiß. Ein Modell kann das ebenfalls tun. Nur kann ich mich nicht darauf verlassen. Genau dieses verlässliche Signal fehlt — und damit die Stelle, an der ein Team üblicherweise merkt, dass es genauer hinschauen sollte.
Zwanzig Änderungen statt einer
Es gibt einen zweiten Effekt, den ich fast interessanter finde. Wenn eine Änderung erheblich weniger Aufwand kostet, macht niemand dieselbe Anzahl Änderungen und geht früher nach Hause. Es werden mehr Änderungen.
Aus der einen Idee, die früher einen halben Tag Implementierung bedeutet hätte, werden fünf Varianten. Noch schnell diese Funktion dazu. Dann könnte man das hier auch gleich umbauen. Und wenn wir schon dabei sind. Das ist einer der großen Vorteile der Technik — und trotzdem kann jede dieser Änderungen etwas beschädigen, das vorher funktioniert hat. Die Änderungen laufen einander über den Weg: zwei Eingriffe, die einzeln harmlos sind, ergeben zusammen einen Fehler, den keiner der beiden allein erzeugt hätte.
Damit steigt die Änderungsrate, und damit der Bedarf an schnellem Feedback.
Wer ausgerechnet jetzt die Testautomatisierung zurückfährt, weil die KI ja selbst Tests schreibt, hat den Mechanismus falsch herum verstanden. Der Bedarf an automatisierter Regression richtet sich nach der Änderungsrate, nicht nach der Teamgröße — und die Änderungsrate ist das, was sich gerade tatsächlich vervielfacht.
Also mehr testen?
Ja, aber nicht nur. Wer immer mehr automatisch erzeugten Code mit immer mehr automatisch erzeugten Tests bewirft, hat am Ende beeindruckende Mengen an Artefakten. Ob dabei das richtige System entstanden ist, weiß er deshalb noch nicht.
Die bisherige Arbeit wird dadurch nicht wertlos. Testfälle schreiben, Regressionen fahren, Oberflächen prüfen bleiben notwendig, und wer behauptet, das erledige jetzt die Maschine, hat es vermutlich nie selbst gemacht. Aber der Schwerpunkt verlagert sich nach vorn.
Ist die Anforderung überhaupt vollständig? Was wurde hineininterpretiert, was nicht dastand? Welche Annahme wurde getroffen, ohne zu fragen? An welcher Stelle im Geschäftsprozess entsteht ein Risiko, das niemand als Testfall formuliert hat, weil es allen zu selbstverständlich war? Und welche dieser Fragen muss beantwortet sein, bevor überhaupt Code entsteht?
Diese Fragen kann nur beantworten, wer den Fachbereich versteht und den Code lesen kann. Nicht zwingend in derselben Person, aber im Prozess braucht es beides. QA verschwindet damit nicht hinter einem Prompt. Sie rückt näher an die Anforderung heran.
Werkzeug, nicht Verantwortlicher
Damit bin ich wieder bei dem, was mich von Anfang an begeistert hat: Das ist ein verdammt leistungsfähiges Werkzeug. Es nimmt mir Fleißarbeit ab, beschleunigt Analysen, schlägt Testfälle vor, erzeugt Varianten, untersucht Code und probiert Dinge aus, für die ich früher keine Zeit gehabt hätte. Ich möchte darauf nicht mehr verzichten.
Was es nicht übernimmt, ist die Verantwortung dafür, dass das Ergebnis stimmt. Die bleibt beim Engineering. Nicht aus philosophischen Gründen, sondern aus einem ziemlich banalen: Auf der anderen Seite ist niemand, dem wir sie geben könnten.
Und die Silver Bullet?
Ist generative KI also die große Abkürzung, auf die die Softwareentwicklung seit Jahrzehnten wartet?
Für einen Teil der Arbeit vielleicht tatsächlich. Sie beseitigt einen Engpass, der uns lange beschäftigt hat: Code lässt sich erheblich schneller erzeugen. Der Rest des Problems verschwindet damit nicht. Der Engpass wandert. Und je mehr wir erzeugen und je schneller wir ändern können, desto wichtiger wird die Frage, ob das entstandene System wirklich das tut, was es tun soll.
Also wieder keine Silver Bullet. Aber ein ziemlich gutes Werkzeug.
KI beschleunigt die Entwicklung. Qualität bleibt eine Engineering-Aufgabe.